知らないことを知らない」AIエージェントが引き起こす未来のリスクシナリオ
数年後、あなたの会社の契約審査、発注、顧客対応の初動を担っているのは、人間ではなくAIエージェントかもしれません。
その未来はすでに、多くの企業で試験導入というかたちで始まっています。
しかし、ここで一つ、あまり語られていない問いがあります。
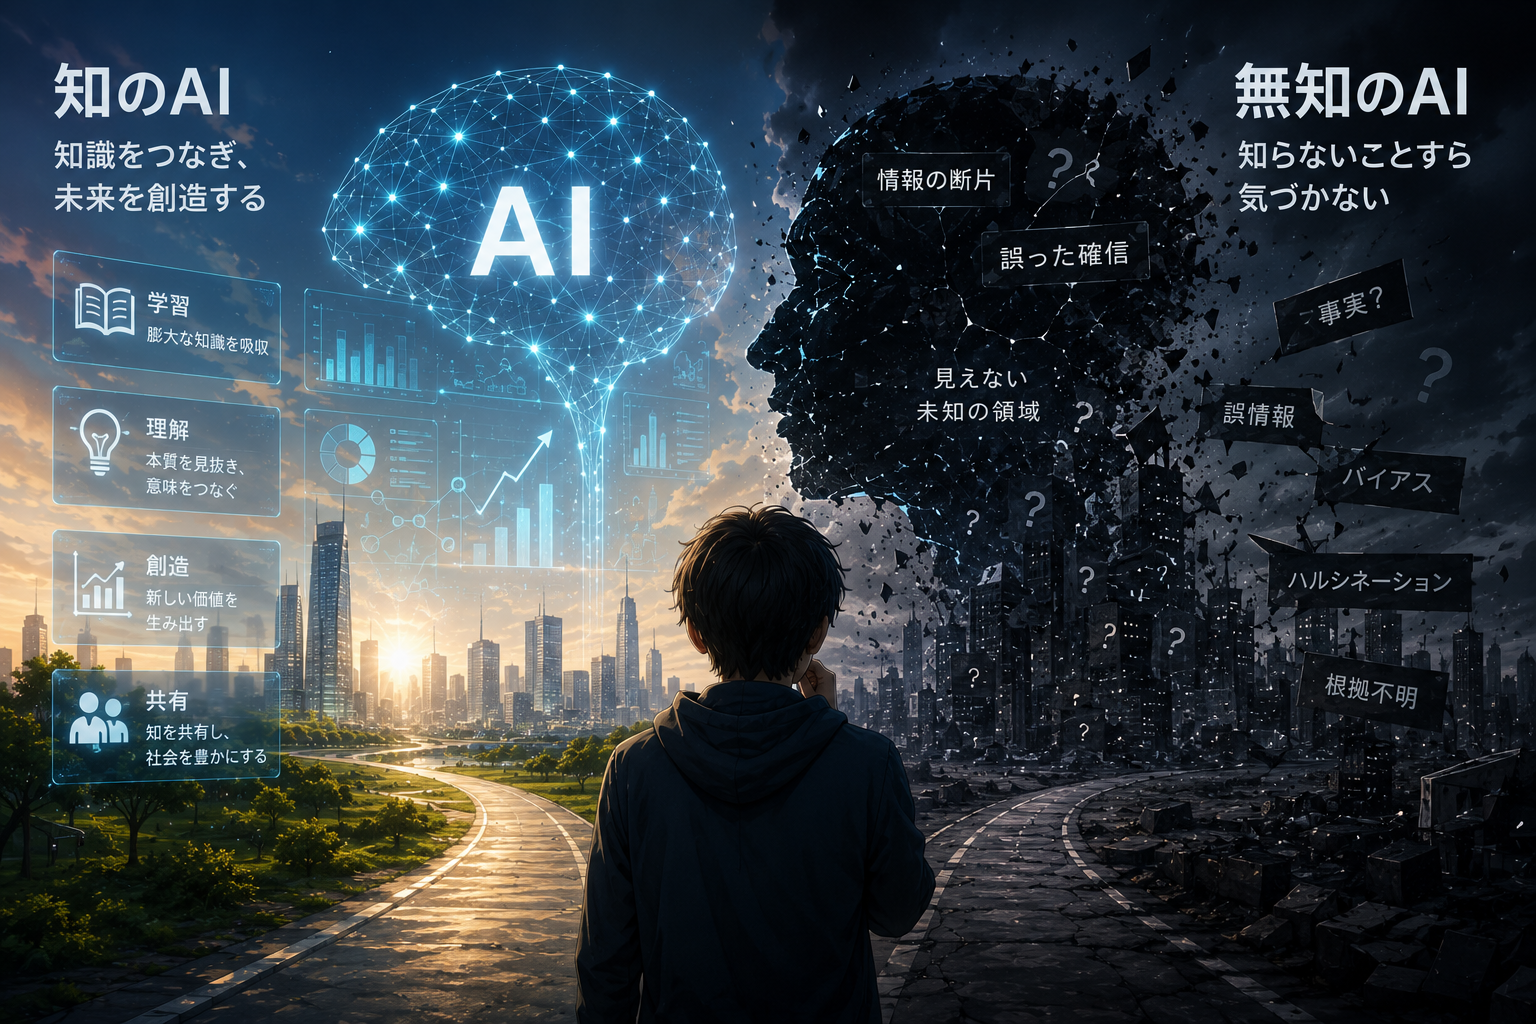
そのAIエージェントは、「自分が判断できない状況」を、自分で認識できるのか。
この記事では、現在のAIが抱える構造的な弱点——メタ認知の欠如——を出発点に、AIエージェントが業務の現場に入り込んだときに起こりうる3つのリスクシナリオを、未来洞察(フォーサイト)の視点で描いてみます。
出発点:AIは「わからない」を自覚できない
現在の大規模言語モデル(LLM)は、本質的には「次に来る単語として最も自然なものは何か」を予測する仕組みで動いています。
そのため、知らないことに対しても、もっともらしい文章を完成させてしまう傾向があります。これがいわゆる「ハルシネーション」です。
人間であれば、難しい質問をされたとき「わかりません」「確認します」と答えられます。これは心理学で「メタ認知」と呼ばれる、自分の知識の限界を把握する能力によるものです。
現在のAIには、このメタ認知にあたる仕組みが十分ではありません。この一点が、AIエージェントが本格的に業務へ組み込まれていく未来において、極めて重要な意味を持ってきます。
シナリオ1:サイレント・オートメーション・リスク(2027〜2028年)
契約書レビューや発注業務の一次処理をAIエージェントが担う企業が増える中、「AIが自信満々に処理した誤り」が、人間のダブルチェックをすり抜けるケースが目立ち始めます。
エージェントは「わかりません」と言わずに処理を完了させてしまうため、エラーが表面化するのは、損害が発生した後になりがちです。
この段階での企業の課題は、AIの回答の「自信度」を可視化する仕組みをどう業務フローに組み込むか、という点に移っていきます。
シナリオ2:エージェント間の連鎖誤作動(2029年前後)
複数のAIエージェントが連携して業務を進める体制が一般化すると、一つのエージェントの誤った前提が、次のエージェントの判断に連鎖的に影響を及ぼすリスクが顕在化します。
人間同士の組織であれば、誰かが「その前提、本当に正しいですか」と疑問を挟む余地があります。しかし、メタ認知を持たないエージェント同士の連携では、その「立ち止まる工程」が抜け落ちやすくなります。
このシナリオが示唆するのは、AIエージェントの設計において、速度や自律性以上に「不確実性を検知して人間にエスカレーションする機能」が競争力の源泉になるという未来です。
シナリオ3:規制とガバナンスの後追い(2028年以降)
AIエージェントによる誤作動が社会的な事故や損害につながる事例が積み重なると、各国の規制当局は「AIに何を判断させてよいか」を巡るルール整備を急ぐことになります。
すでに米中間ではAIガバナンスを巡るアプローチの違いが顕在化しており、企業は「どの規制圏で、どのAIエージェントを、どこまで自律的に動かせるか」という複雑な判断を迫られる未来が見えてきます。
この未来に、今から備えるとしたら
3つのシナリオに共通するのは、「AIエージェントの能力」そのものよりも、「AIエージェントが自分の限界を認識し、人間に立ち止まりを求められるかどうか」が最大の変数になる、という点です。
今の段階でできることは、決して難しいことではありません。
- 重要な意思決定の手前に、必ず人間の確認ポイントを設計しておく
- AIに「不確実な場合は明示してください」と指示する運用ルールを持つ
- 複数のAIエージェントを連携させる場合は、前提条件を人間が定期的に検証する
未来は、AIの性能だけで決まるわけではありません。人間がAIの弱点をどれだけ正確に理解し、設計に組み込めるかによって、大きく変わってきます。
AIがなぜ「知らない」を知らないのか、その根本的な仕組みについては、こちらの記事で詳しく解説しています。
このテーマをさらに深く掘り下げるシリーズを、Substack「AI文明の生き方」で継続的に発信しています。
この記事をシェアする